先说这个项目的热度:Strata 9 月 24 日才建仓,截至 10 月 27 日,GitHub 上已有 34,012 star、3,646 fork,平均每天新增 1,000 star 上下。10 月上旬约 2 万,10 月 20 日前后约 2.9 万,最近一周又涨了 5,000 多,同期一共发了 60 个 release。
我在自己的游戏 PC 上用 Strata 跑起了 Qwen3.8-Flash-Next:125B 的 MoE 模型,IQ3_S 约 3-bit IQ型量化,惊呆了😄
跑起来之后问题只有一个:压到 3-bit,到底损失了多少? 体感不算数,简单测一测吧~
对照组:Qoder 托管的同名生产版 Qwen3.8-Flash。同一个基座,一边开源预览权重 + 3-bit + 消费级显卡,一边云端满血版对比。
⚙️ 125B 是怎么塞进游戏 PC 的
先简单分析下项目的原理:秘诀在多级"缓存"的分工。
BF16 权重 250 GB ──IQ3_S 量化──▶ 总量 83.6 GB ──按热度分层──▶ VRAM / RAM / SSD
每个 token:24,576 个 expert 只点亮 10 个 → 真正计算的只有 ≈6B 参数
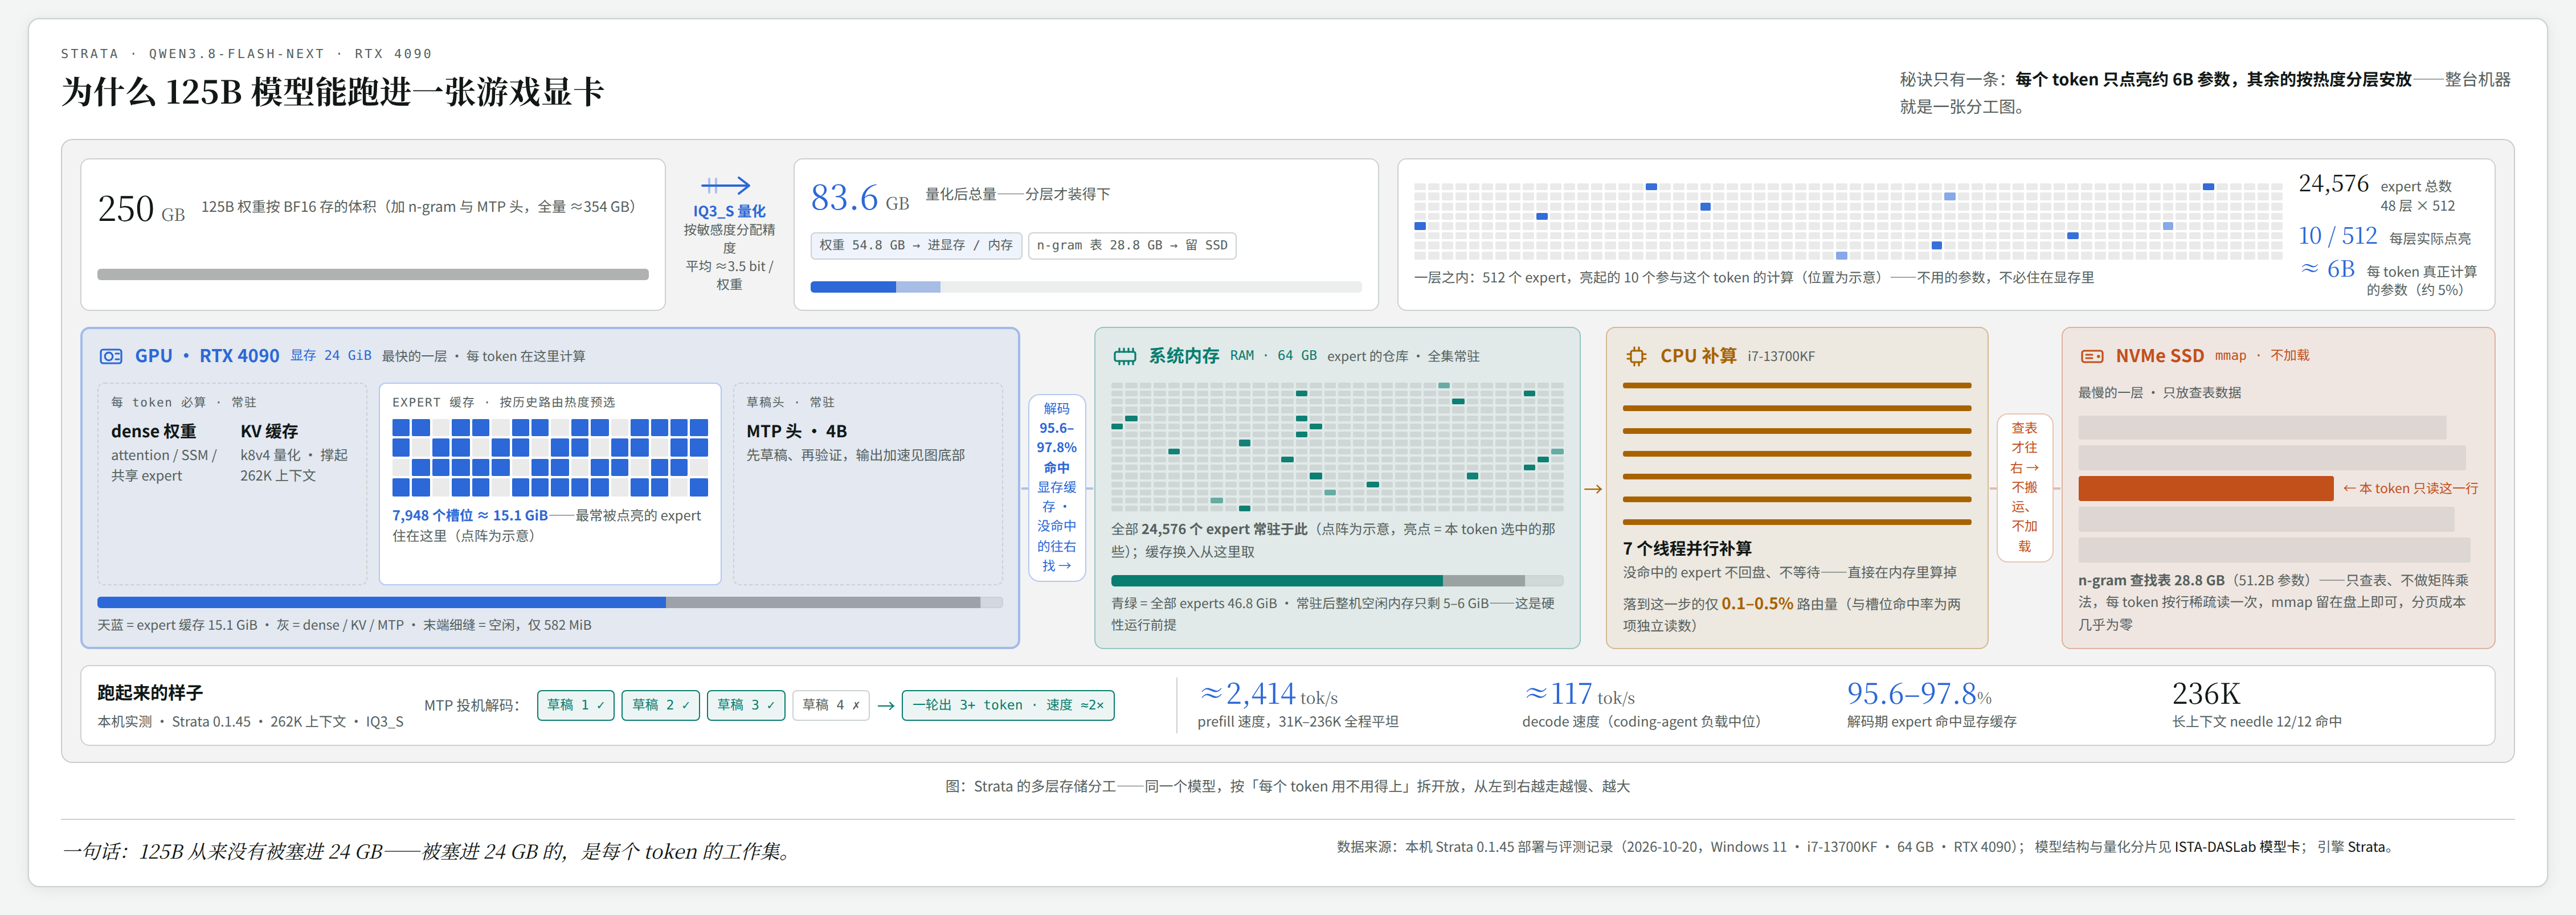
图:同一个模型,按「每个 token 用不用得上」拆开放,从左到右越走越慢、越大。
- MoE 稀疏激活是前提:每 token 只算约 5% 的参数,其余 expert 不必常驻显存
- GPU 只放必算件 + 热点 expert 缓存(7,948 个槽位,解码实测命中率 95.6–97.8%),没命中的由 CPU 在内存里并行补算
- SSD 上 28.8 GB 的 n-gram 查找表走 mmap,每 token 只读一行;再加 MTP 投机解码,草稿先行、验证跟上,速度 ≈2×
📊 评测设计
简单评测,仅作参考
- 同一 harness:两侧都由 qodercli 驱动,参数逐字相同,只换
-m;上下文统一 262,144、最大输出 32,768、思考预算 16,384,工具集封锁、MCP 强制为空 - Track A · 编程任务对照:12 道 agentic 编程任务 × 每题 3 次 × 两侧 = 72 次运行,0 作废;双通道判分——确定性程序判分 + Kimi-K3 盲评
- Track B · 原始能力画像(仅本地,直连 API):长上下文 needle、工具调用、幻觉探测、严格格式
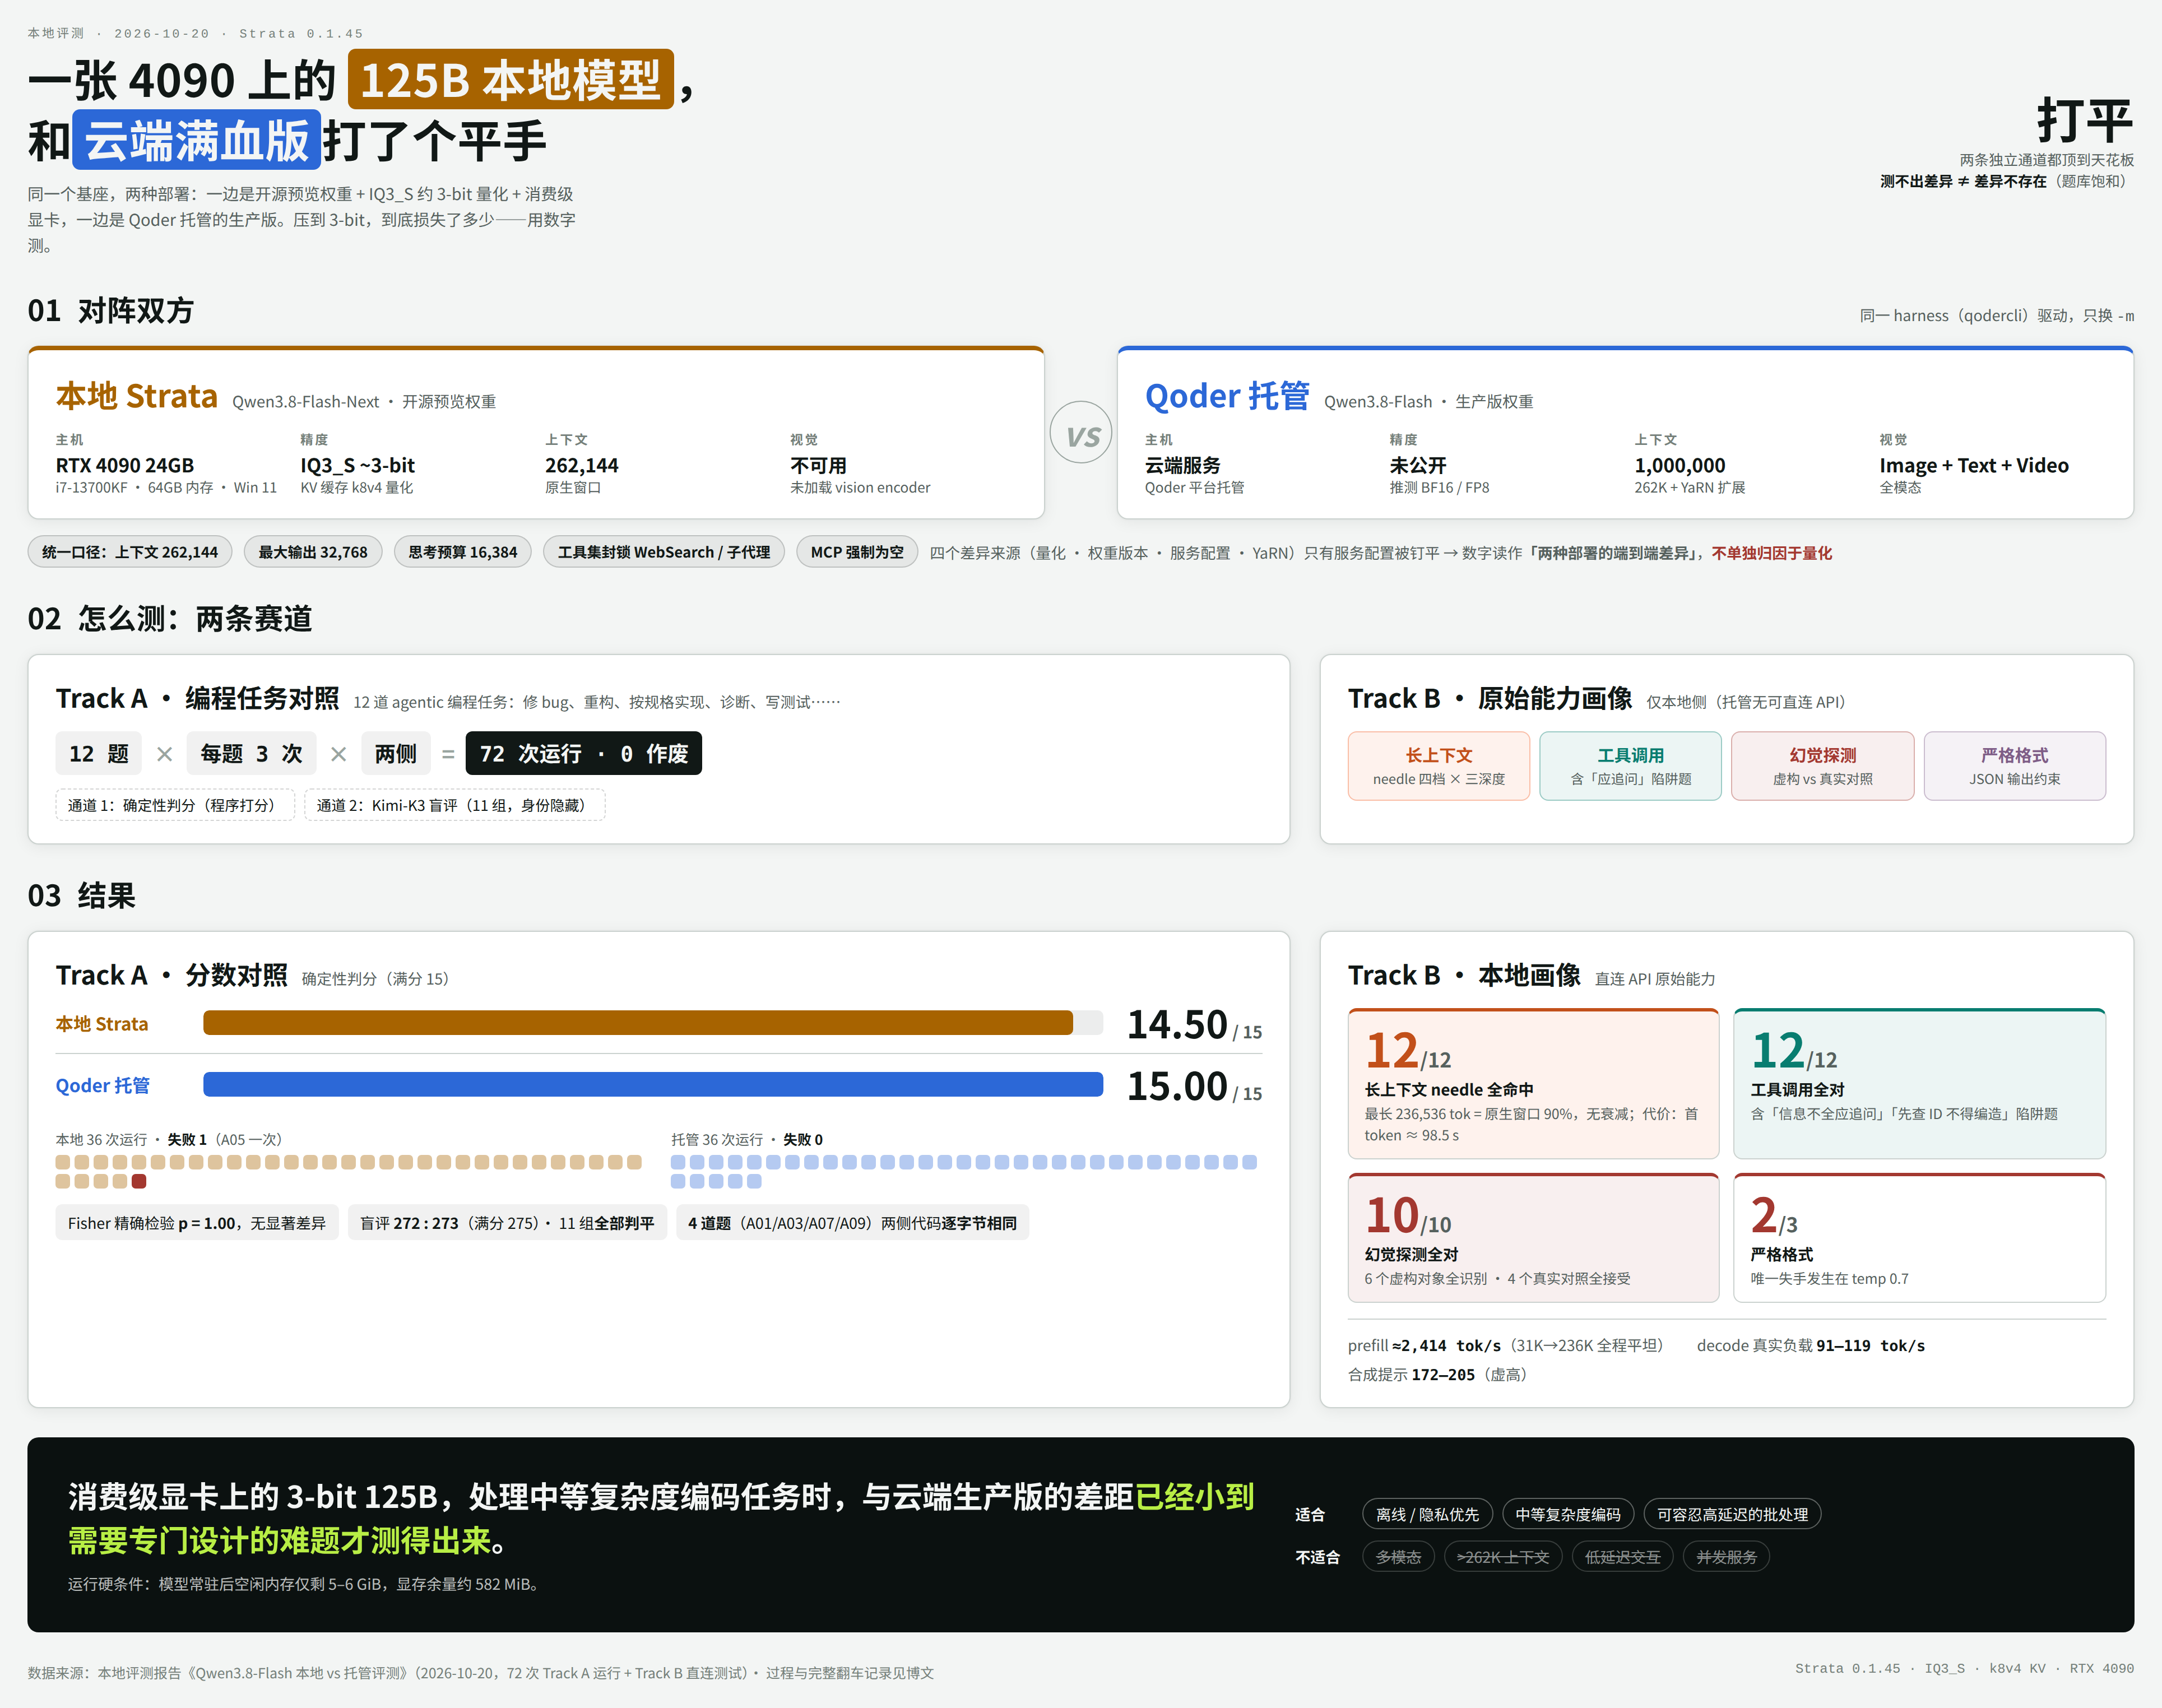
图:评测速览——怎么测、结果如何,一张图看完。
📋 具体测了什么
12 道题都是日常工程活,不是选择题;跑题和判分全由脚本执行,不是人打分。
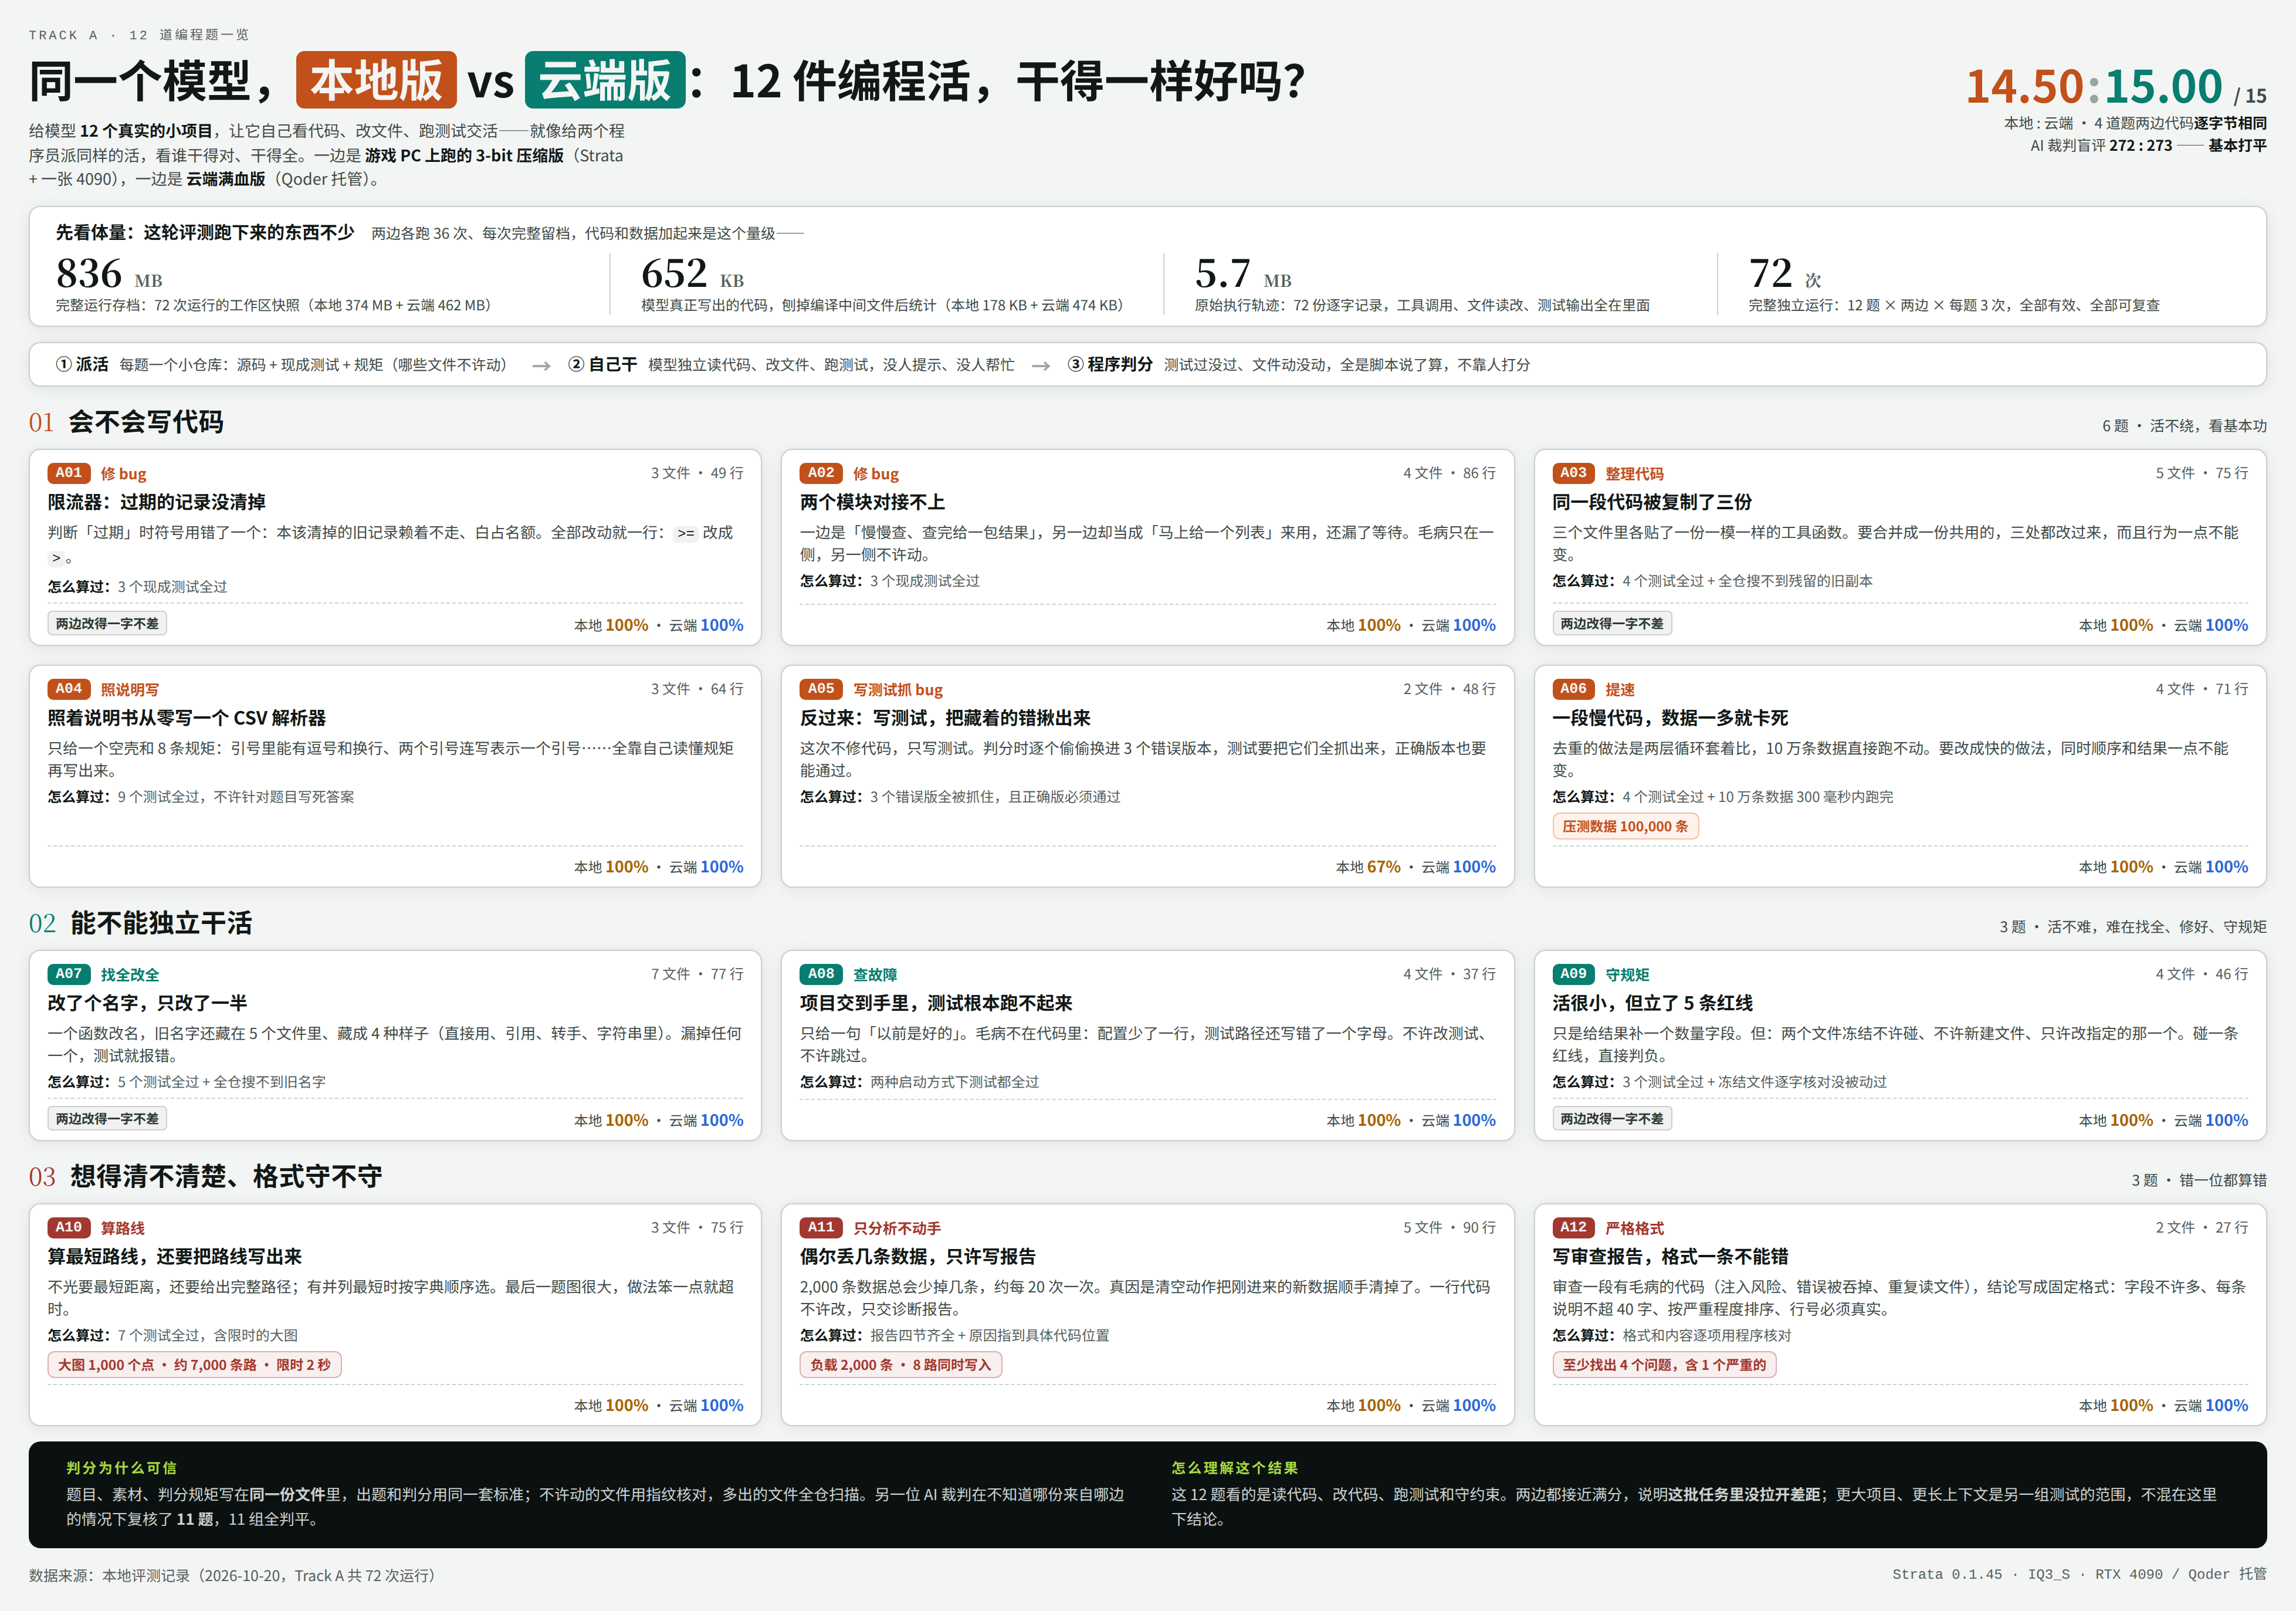
图:12 道题一览——12 道题分别在测什么、怎么判分,一张图看完。
本地丢的 0.5 分出在 A05:不是漏检,是模型自己的测试比规格卡得更严。
顺带说一下这次评测的数据体量:72 次运行的完整沙盒快照一共 836 MB(本地 374 MB + 托管 462 MB),原始 stream 轨迹本地 2.7 MB、托管 3.0 MB。不过别被 836 MB 吓到:排除 A11 的 .build 编译中间产物后,两侧模型真正写出来的代码只有本地 178 KB、托管 474 KB——99% 都是编译噪声,打包分享记得排除 .build。
🎯 结果:基本打平👍
- 确定性判分:本地 14.50 / 15 vs 托管 15.00 / 15,Fisher 精确检验 p = 1.00,无显著差异
- 盲评 272 : 273(满分 275),11 组全部判平;12 题里有 4 题两侧代码逐字节相同
- Track B 结果(合计 41/42):needle 12/12(最长 236,536 tok = 原生窗口 90%)、工具调用 12/12、幻觉探测 10/10、严格格式 2/3
- 速度:prefill ≈2,414 tok/s 全程平坦;decode 真实负载 91–119 tok/s。代价是延迟——236K 上下文时首 token 要等 ≈98.5 s
两条通道都顶到了天花板,测不出差异 ≠ 差异不存在,只能说这套题库的分辨率不够。两侧的差异来源有四个(量化、权重版本、服务配置、YaRN),目前只初步平衡了服务配置,所以仅作参考。
还有两条边界得说清:盲评只覆盖了 11 道题,缺的正是 A05——别写成"12 题全部盲评";Track A 上下文占用峰值才 23% 左右,长上下文的结论只来自 Track B,而且 Track B 只有本地侧、没有托管对照。
🔭 往前看:消费级PC的「满血」本地大模型时刻
一个过去只能跑在专业机房里的 125B 模型,现在跑在了一台游戏 PC 上。
MoE 让每 token 真正计算的参数只有约 6B,量化与分层 offloading 每一代都在变成熟,消费级内存容量和 CPU-GPU 互联也在往上走。Strata 这类为单一模型手写的专用引擎,极限优化后,非常有潜力!
下一代消费级 PC 上,「满血」可能不再是云端的专有名词——大模型在本地跑起来、数据不出家门、断网也能用,会从极客的折腾变成默认选项。云端的优势会收缩到真正的前沿规模和多模态,而日常的编码、写作、Agent 任务,会越来越多地发生在你桌子底下那台机器里,期待!